Une réponse d’IA qui s’affiche presque immédiatement peut changer le confort d’une application. Mais si le logiciel attend ensuite un fichier, un service extérieur ou une validation, le travail reste bloqué. L’annonce de GPT-6 Astra Ultrafast invite à regarder précisément où se situe l’attente avant de payer pour une accélération.
Pour une entreprise qui utilise déjà une application reliée à une IA, la question est concrète : faut-il activer un mode plus rapide, simplifier le circuit ou conserver le réglage actuel ? Voici une manière de distinguer ces situations, avec un exemple entièrement fictif et une fiche de diagnostic à transmettre à votre prestataire.
Ce qui a été annoncé, et ce qui est disponible
Le 1er octobre 2026, NVIDIA a présenté l’accélération de GPT-6 Astra Ultrafast sur ses processeurs Blackwell. L’entreprise annonce une génération de tokens jusqu’à huit fois plus rapide que le mode Astra Standard. Un token est une unité de texte traitée par le modèle, parfois un morceau de mot. Ce chiffre décrit une performance annoncée par le fournisseur, pas un gain de productivité constaté par notre rédaction.
La documentation OpenAI consultée le 2 octobre confirme que le mode Ultrafast de GPT-6 Astra est disponible aux utilisateurs de l’API, avec des limites de débit. Une API permet à un logiciel de demander un résultat à un service. Le mode se choisit dans la requête ; sa rapidité s’accompagne d’un coût supérieur. L’accès à une application utilisant l’API ne signifie donc pas qu’elle active automatiquement cette option.
NVIDIA mentionne également des utilisateurs éligibles de ChatGPT Work et Codex. Cela ne permet pas de conclure que tous les abonnements disposent du même accès. Vérifiez l’option réellement proposée dans votre environnement et les conditions applicables avant tout engagement.
Le point à vérifier d’abord : le lieu de traitement
Le guide OpenAI indique que ce mode prend en charge la résidence des données aux États-Unis et le traitement global, mais pas les points d’accès de traitement régional européens ni les autres régions hors États-Unis. Cette restriction concerne le mode Ultrafast décrit dans ce document. Elle ne résume pas toutes les possibilités des autres services du fournisseur.
Pour votre diagnostic, commencez par une question écrite : « Notre application a-t-elle une exigence de traitement dans une région précise, et cette option la respecte-t-elle ? » Demandez au responsable du contrat ou au prestataire de confirmer la réponse pour le service effectivement utilisé. N’en déduisez pas, à partir du seul nom du modèle, que votre configuration habituelle reste identique.
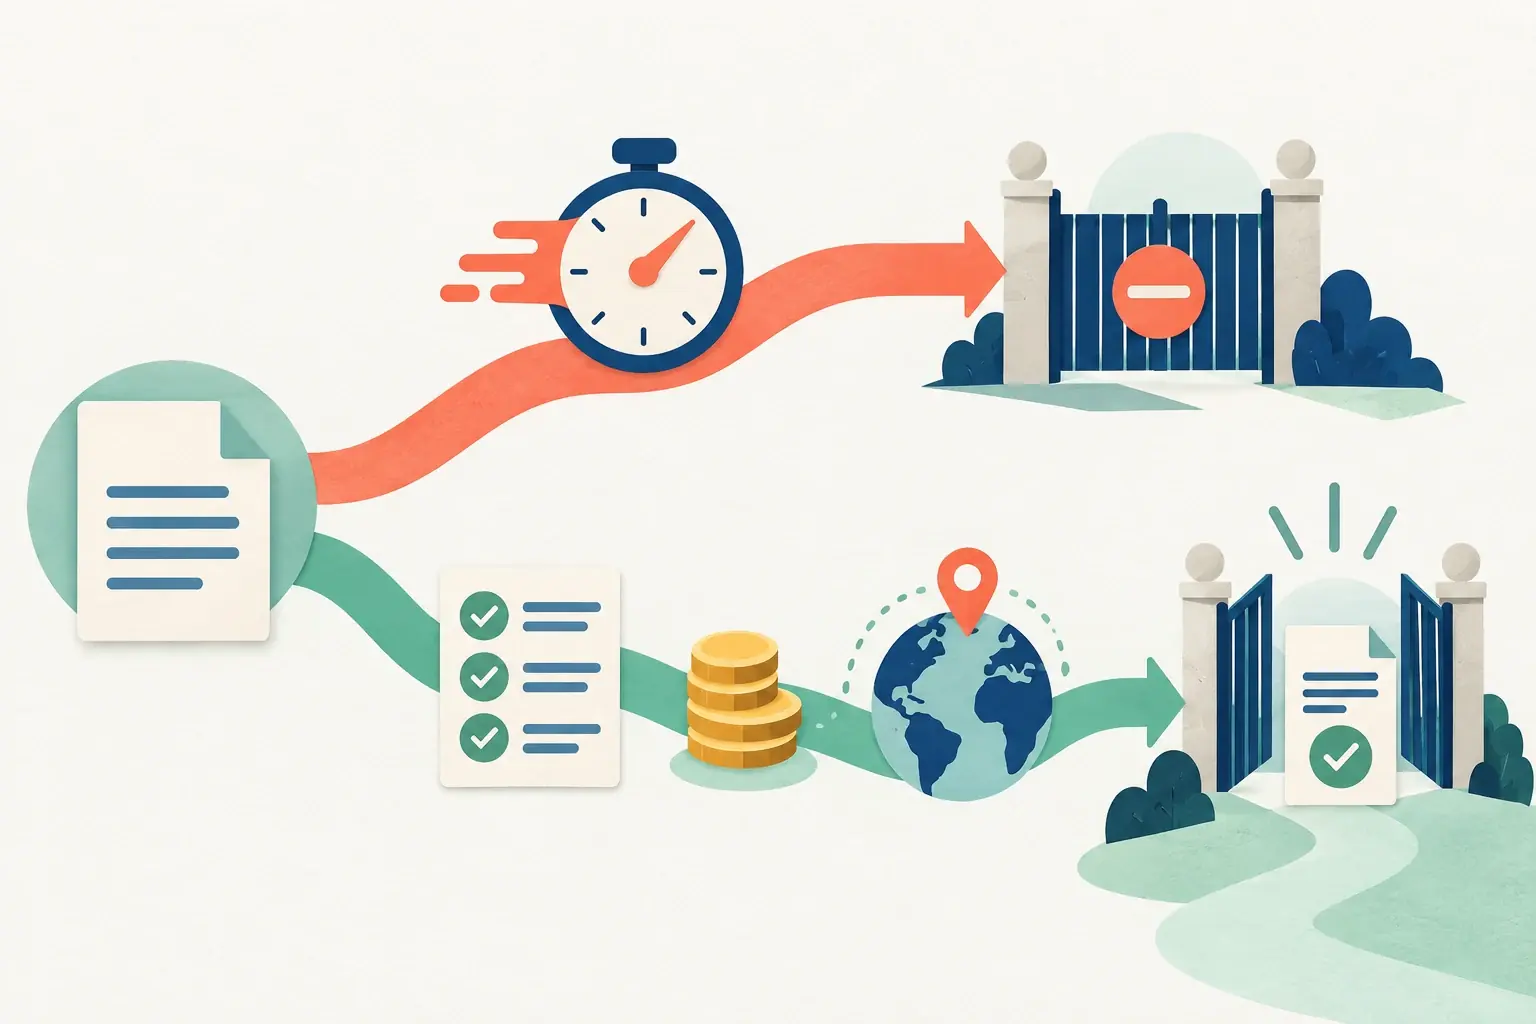
Si cette condition est incompatible avec votre cadre de travail, l’essai s’arrête à ce stade. Vous pouvez chercher à réduire les attentes dans le circuit existant sans activer ce mode. Il n’est pas nécessaire de transférer de vrais dossiers pour découvrir qu’une condition d’usage ne correspond pas au besoin. Pour les questions juridiques ou contractuelles propres à vos données, faites examiner la configuration par les personnes compétentes.
Une application peut attendre à plusieurs endroits
OpenAI distingue, dans son guide technique sur la latence, plusieurs leviers : accélérer le traitement, réduire le texte généré, limiter les requêtes et exécuter en parallèle les opérations indépendantes. La latence désigne le délai observé avant ou pendant la réponse d’un système. Elle ne se réduit pas au débit du modèle.
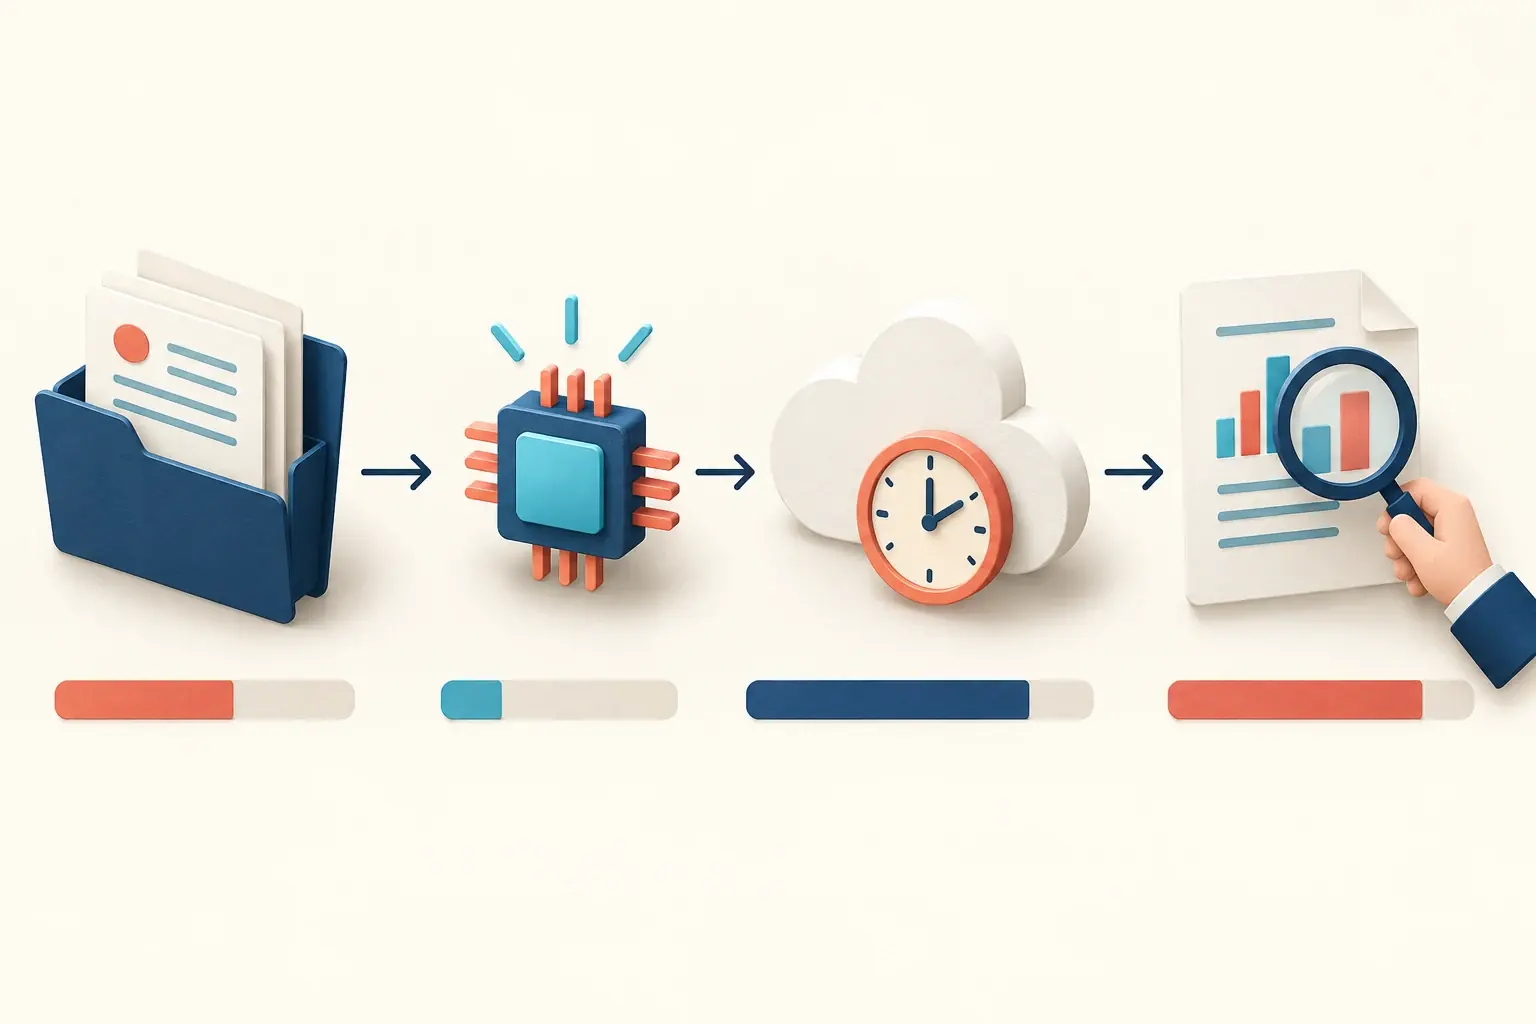
Imaginez un parcours en quatre étapes : l’application rassemble les pièces, le modèle prépare un texte, un outil retrouve une information, puis une personne contrôle le résultat. Chaque étape a son attente propre. Un service de génération plus rapide agit sur une partie du parcours. Il ne rend pas automatiquement plus rapide la récupération d’un document dans un autre logiciel.
Pour rendre ce problème visible, proposez à votre prestataire de tracer une seule demande du début à la fin. Le relevé doit identifier les changements d’étape, sans enregistrer inutilement le contenu confidentiel des documents. Ce qui vous intéresse ici est le moment où chaque opération commence et se termine, ainsi que les éventuelles reprises.
Un exemple fictif pour comprendre la limite du chiffre
Prenons l’entreprise fictive Atelier Ligne, qui prépare une note à partir de fiches techniques. Dans notre scénario inventé, le circuit prend quarante secondes : dix pour rassembler les documents, huit pour générer le texte, douze pour obtenir une réponse du catalogue et dix pour contrôler automatiquement le format. Ces durées servent uniquement à expliquer le raisonnement ; elles ne décrivent ni une mesure d’Astra ni une entreprise réelle.
Supposons maintenant, uniquement pour le calcul, que les huit secondes de génération deviennent une seconde et que tout le reste reste identique. Le circuit passe de quarante à trente-trois secondes. La génération est huit fois plus rapide, tandis que le délai total baisse de sept secondes. Le résultat final n’arrive pas huit fois plus vite. Ce calcul ne prédit pas la performance du service annoncé.
Cette différence devient décisive lorsque vous comparez le supplément de coût à l’attente réellement évitée. Si les utilisateurs doivent rester devant l’écran pour poursuivre immédiatement, quelques secondes peuvent avoir un intérêt. Si le rapport est préparé pendant la nuit, la même réduction peut ne changer aucune décision. Décrivez donc le moment où le résultat est nécessaire avant de choisir le réglage.
Trois décisions différentes selon le goulot d’attente
La génération occupe une grande partie du délai. Un mode plus rapide mérite alors un essai ciblé, sous réserve des conditions de traitement et du coût. Demandez d’abord un résultat de taille adaptée. Si l’équipe a besoin d’un tableau de cinq lignes, produire une longue introduction ne lui rend pas service. Gardez les informations nécessaires à la compréhension et au contrôle.
L’application multiplie les allers-retours. Faites examiner le circuit avant de changer de mode. Plusieurs demandes successives peuvent parfois être regroupées ; des recherches indépendantes peuvent être effectuées ensemble. Le prestataire doit vérifier les dépendances : on ne peut pas lancer une opération qui nécessite un résultat encore inconnu. Le regroupement ne doit pas supprimer une validation indispensable.
Un outil extérieur ou une relecture domine l’attente. Travaillez d’abord sur ce passage : document mieux rangé, source disponible, format plus facile à contrôler, responsabilité claire. L’article consacré à la répartition des responsabilités avec les agents IA aide à préciser qui reprend le résultat et dans quelles conditions. Le problème peut être organisationnel même lorsque l’écran donne l’impression d’une lenteur technique.
Ces choix sont des pistes de diagnostic proposées par la rédaction. Ils ne constituent pas un classement de produits. Une même application peut présenter plusieurs goulots ; corrigez celui que le relevé rend visible, puis observez le parcours à nouveau.
La fiche à envoyer à votre prestataire
Vous pouvez préparer cette demande sans maîtriser le développement informatique. Choisissez une tâche habituelle et remplissez les éléments suivants sur une page. Utilisez un dossier fictif ou autorisé pour le premier relevé, puis convenez des conditions d’un éventuel essai avec les documents de travail.
- Le résultat attendu : une note, un tableau ou un fichier précisément défini, avec le moment où il doit être disponible.
- Les passages observables : envoi de la demande, début de réponse, fin de génération, retour des outils, résultat utilisable.
- La configuration : modèle, mode, longueur demandée et services appelés, afin de comparer des circuits équivalents.
- Les contraintes : traitement des données, plafond de dépense, permissions et procédure de retour au réglage précédent.
- Les défauts à conserver dans le relevé : réponse incomplète, nouvelle tentative, erreur d’outil ou correction importante.
Demandez plusieurs observations à des moments représentatifs. Une capture d’écran réussie ou un essai isolé ne suffit pas à décrire le comportement du circuit. Gardez les essais ratés dans le bilan : les retirer rendrait la comparaison plus séduisante et moins utile.
Évitez aussi de modifier simultanément le modèle, les instructions et les documents. Si le résultat s’améliore, vous ne saurez plus à quel changement l’attribuer. Pour préparer le contrôle du contenu, notre guide vérifier une réponse d’IA avant utilisation fournit une lecture complémentaire ; le présent dossier s’intéresse surtout aux attentes du circuit et à leur coût.
Dépenser plus uniquement là où l’attente a un effet
Demandez un coût par tâche achevée, en incluant les tentatives supplémentaires, plutôt qu’un tarif présenté sans scénario d’usage. Cette proposition permet de rapprocher la facture du résultat utile. N’annoncez pas une économie tant que vous ne disposez pas des observations et de la consommation correspondantes. Aucun prix ni budget universel n’est nécessaire pour conduire ce diagnostic.
Dans une application qui le permet, le prestataire peut étudier des réglages différents selon les tâches : une demande interactive et un traitement différé n’ont pas la même contrainte. Cette séparation doit rester compréhensible et documentée. L’utilisateur doit savoir quand le résultat est terminé et ce qui demeure à vérifier, même si du texte apparaît progressivement à l’écran.
Si vous ne contrôlez pas l’intégration technique, ne cherchez pas une option cachée. Transmettez plutôt la fiche au fournisseur de votre application et demandez quelles améliorations il peut effectivement proposer. Pour choisir un usage avant toute modification, le parcours intégrer l’IA dans une PME reste un point d’entrée adapté.
La décision utile tient dans une phrase vérifiable : « Nous activons cette option pour cette tâche, parce que l’attente observée gêne cet usage, dans ces conditions de coût et de traitement. » Si vous ne pouvez pas encore remplir cette phrase, le relevé du circuit est la prochaine étape. La nouveauté mérite alors une investigation, pas une généralisation immédiate.
Repère éditorial : analyse de l’annonce NVIDIA du 1er octobre 2026 et des guides OpenAI Ultrafast mode et Latency optimization, consultés le 2 octobre. La rédaction n’a pas testé le service. La fiche et le scénario Atelier Ligne sont des propositions originales ; les chiffres du scénario sont fictifs.
Relier cette méthode à votre organisation
Pour compléter ce dossier : Encore la même décision en réunion ? Fixez les conditions pour la revoir ; « On pourrait aussi… » : arbitrer les ajouts sans faire dérailler votre projet. Ces guides abordent des décisions complémentaires, du choix d’une prochaine action aux conditions de sa réalisation.