Publicité · liens affiliés
Les poids de Beam sont désormais disponibles. Pour une entreprise qui souhaite garder la main sur son assistant de programmation, l'annonce est intéressante : elle ouvre un choix d'hébergement et d'adaptation. Elle ne transforme pourtant pas ce modèle en logiciel léger à installer sur l'ordinateur d'un développeur.
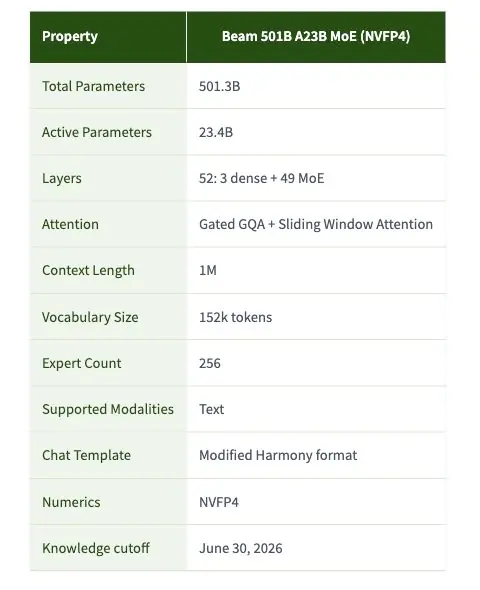
Reflection a annoncé la disponibilité le 16 octobre 2026, après une première présentation le 5 octobre. Le même jour, AWS a publié son guide d'hébergement. Le point à retenir avant de comparer les offres tient dans deux nombres : environ 501 milliards de paramètres au total, dont 23 milliards actifs. Le second éclaire le calcul effectué par le modèle. Il ne remplace pas le premier pour préparer l'infrastructure.
Ce qui devient accessible avec cette publication
Reflection présente Beam comme un modèle destiné au code, au raisonnement et aux tâches comportant plusieurs étapes. Les poids sont distribués sous licence Apache 2.0. L'entreprise propose également un accès par API et décrit des intégrations avec des outils d'agents. Ces chemins répondent à des besoins différents : appeler un service hébergé et exploiter soi-même les poids ne mobilisent pas la même équipe.
La disponibilité ne suffit donc pas à trancher une décision d'achat. Une petite structure peut vouloir évaluer la qualité des corrections de code sans administrer de serveurs. Une organisation disposant déjà d'une équipe spécialisée peut examiner un hébergement qu'elle contrôle davantage. Dans les deux cas, le projet commence par le travail attendu de l'assistant, puis par les conditions acceptables pour le réaliser.
Il faut aussi distinguer les annonces du fournisseur d'un résultat observé dans votre environnement. Les démonstrations de Reflection illustrent des usages ; elles ne constituent pas une garantie que votre dépôt, vos outils et vos règles internes produiront le même résultat. Aucun test indépendant du modèle n'est présenté dans cet article.
501 milliards au total, 23 milliards actifs : pourquoi cela compte
La fiche de Beam décrit une architecture à mélange d'experts, ou MoE. Le modèle utilise une partie de ses paramètres pour traiter chaque jeton de texte. C'est ce que désigne le nombre de paramètres actifs. Les autres paramètres appartiennent néanmoins au modèle à stocker et à servir. Un chiffre d'activité réduit ne signifie donc pas que tout le reste disparaît de la mémoire nécessaire.
Un calcul volontairement simplifié aide à voir l'ordre de grandeur. À deux octets par paramètre, 501 milliards de paramètres représentent environ 1 002 milliards d'octets, soit un peu plus d'un téraoctet décimal. Ce calcul porte uniquement sur les poids dans cette représentation théorique. Il ne décrit ni la taille exacte d'un téléchargement, ni la mémoire totale requise, ni le coût d'une installation fonctionnelle.
Reflection publie plusieurs représentations numériques, dont BF16, FP8 et NVFP4. Elles modifient l'empreinte des poids et les contraintes de compatibilité. Il faut ajouter aux poids la mémoire de travail et celle qui sert au traitement du contexte. Le dimensionnement dépend aussi du nombre de requêtes traitées en même temps. AWS indique ainsi une exploitation sur plusieurs GPU pour Beam. Le sigle du format choisi ne constitue pas, à lui seul, une fiche de dimensionnement.
Choisir qui exploite le service avant de choisir la machine
Dans son guide du 16 octobre, AWS distingue un accès géré par SageMaker JumpStart et des chemins donnant davantage de contrôle sur l'infrastructure avec HyperPod Inference. Au lancement, l'accès JumpStart annoncé concerne les régions américaines Virginie du Nord et Ohio. Cette indication mérite d'être examinée avant de bâtir un projet qui exige un lieu de traitement particulier.
Pour comparer les solutions, demandez qui assure les mises à jour, le suivi des incidents et l'ajustement de capacité. Un service géré peut prendre en charge certaines opérations tout en vous laissant la responsabilité des données envoyées et des droits accordés à l'agent. Un hébergement plus autonome augmente les choix possibles, mais demande de préciser qui sera disponible lorsqu'une requête échouera ou que la capacité deviendra insuffisante.
Rassemblez ces réponses dans une estimation portant sur l'usage complet. Notre guide pour comparer un modèle IA par son coût et son résultat aide à poser ce cadre. Pour Beam, ajoutez explicitement le travail d'exploitation. Un prix par jeton ou une liste de poids téléchargeables laisse cette partie du dossier ouverte.
Les poids ouverts n'établissent pas non plus, par eux-mêmes, la confidentialité d'une installation. Le lieu de traitement, les journaux conservés et les accès aux outils restent des décisions d'architecture. Examinez le chemin réel des données plutôt que de déduire une protection du seul mode de distribution du modèle.
Le contexte long ne dispense pas de sélectionner les informations
La fiche technique annonce une fenêtre de contexte d'un million de jetons et précise que le modèle a été développé principalement pour l'anglais. Beam prend du texte en entrée et en produit en sortie. Ces caractéristiques donnent des repères pour préparer un essai ; elles n'attestent pas une compréhension parfaite d'un dépôt entier ou de toutes les consignes en français.
Dans un cas fictif, une équipe veut faire corriger une erreur dans son module de facturation. Elle peut commencer par fournir le comportement attendu, le test qui échoue et les fichiers concernés. Charger tout le dépôt dès le départ rendrait plus difficile l'analyse d'un résultat décevant : le problème viendrait-il des informations disponibles, de la demande ou des actions exécutées ?
Le même principe s'applique aux outils. Un assistant chargé de proposer une correction n'a pas nécessairement besoin de modifier la production. Définir un périmètre lisible permet de comparer plusieurs essais. C'est aussi l'intérêt de limiter les outils proposés à un agent IA aux actions utiles pour la tâche en cours.
Préparer un essai qui éclaire une décision d'exploitation
Choisissez des tâches déjà comprises par votre équipe : un défaut reproductible, une modification limitée et un cas où l'assistant doit reconnaître qu'il manque une information. Conservez la version du modèle, son format numérique et les réglages utilisés. Si vous changez plusieurs éléments entre deux essais, la comparaison devient moins informative.
Pour chaque tâche, relevez le résultat utilisable, les corrections humaines nécessaires et le temps écoulé jusqu'à la validation. Ajoutez le volume de requêtes que vous attendez réellement. Un essai isolé satisfaisant laisse encore à examiner le comportement lorsque plusieurs collègues utilisent le service. Ces observations constituent un dossier de décision, sans promettre de reproduire un classement public.
L'annonce de fin de l'agent ne doit pas clore cet examen. Vérifiez les tests, les fichiers modifiés et les effets de la correction. Notre article sur la manière de contrôler le résultat annoncé par un agent détaille cette distinction. Elle reste valable quel que soit le modèle et quel que soit l'hébergeur retenu.
Une lecture pour relier le modèle à l'application
AI Engineering: Building Applications with Foundation Models, de Chip Huyen, traite de la construction d'applications à partir de modèles existants. La présentation de l'éditeur aborde notamment le choix des modèles, leur évaluation et les difficultés de coût et de latence. C'est une référence technique en anglais pour une équipe qui doit examiner l'ensemble du système, au-delà d'une annonce de modèle.
L'ouvrage précède la sortie de Beam et n'en constitue pas un guide d'installation. Son intérêt ici est d'aider à poser les questions d'ingénierie qui restent après le téléchargement des poids. Pour décider de la suite, demandez à l'équipe un résultat attendu, un responsable d'exploitation et les conditions mesurables d'un essai limité. La possibilité d'héberger le modèle devient alors un choix que l'on peut examiner concrètement.